GPU는 원래 게임 화면을 그리기 위해 발전한 그래픽 처리 장치였다. 그런데 지금은 ChatGPT 같은 생성형 AI를 개발하는 데 수천 개, 많게는 수만 개의 GPU가 동시에 투입된다. 그래픽카드가 도대체 AI와 무슨 관계가 있기에 이런 일이 벌어진 걸까.
답은 의외로 단순하다. 게임 화면을 만들기 위해 발전한 GPU의 ‘수많은 숫자를 동시에 계산하는 능력’이 거대한 행렬 계산을 반복하는 현대 AI와 매우 잘 맞았기 때문이다.
이 글에서 이해할 핵심
GPU가 AI를 이해하거나 생각하는 것은 아니다. AI가 학습하고 답변을 생성할 때 필요한 엄청난 양의 곱셈과 덧셈을 빠르게 처리하는 계산 엔진에 가깝다. 이 원리를 이해하면 NVIDIA뿐 아니라 AMD, HBM, 데이터센터, 전력 그리고 Google·Amazon·Meta 같은 빅테크의 AI 투자까지 하나의 구조로 연결해서 볼 수 있다.
GPU가 많이 필요한 세 가지 이유
AI에 많은 GPU가 필요한 이유를 크게 나누면 세 가지다.
- 계산량: AI가 처리해야 하는 곱셈과 덧셈의 양 자체가 엄청나게 많다.
- 메모리: 거대한 모델과 학습 과정에서 발생하는 여러 데이터를 GPU 한 장의 메모리에 담기 어렵다.
- 시간: 한 장으로 처리하면 학습이 너무 오래 걸리기 때문에 여러 GPU에 계산을 나눠야 한다.
이 세 가지를 이해하려면 먼저 CPU와 GPU가 왜 다르게 만들어졌는지부터 봐야 한다.
GPU는 원래 그래픽카드인데 왜 AI에 쓰일까
게임 화면은 수많은 픽셀과 3D 오브젝트로 구성된다. 화면을 그리려면 각각의 위치와 색상, 빛, 그림자, 질감 같은 값을 계속 계산해야 한다.
이런 작업에는 특징이 있다. 서로 비슷한 계산 상당수를 동시에 나눠 처리할 수 있다는 점이다.
GPU는 그래서 복잡한 문제 하나를 순서대로 빠르게 해결하는 것보다 수많은 유사 계산을 한꺼번에 수행해 전체 처리량을 높이는 방향으로 발전했다.
NVIDIA는 2006년 CUDA를 도입했다. GPU의 대규모 병렬 처리 능력을 그래픽 API와 관계없는 일반 계산에도 사용할 수 있게 한 것이다. 현재 NVIDIA의 CUDA 공식 문서에서도 GPU가 3D 그래픽용 특수 프로세서에서 출발해 생성형 AI와 대규모 언어모델을 포함한 범용 계산 가속기로 발전한 과정을 설명하고 있다.
순서를 거꾸로 생각하면 안 된다.
AI를 위해 GPU가 만들어진 것이 아니다. 게임 때문에 대규모 병렬 계산에 강한 장치가 발전했고, 나중에 연구자들이 보니 딥러닝 역시 이런 계산 구조와 매우 잘 맞았던 것이다.
CPU와 GPU는 무엇이 다를까
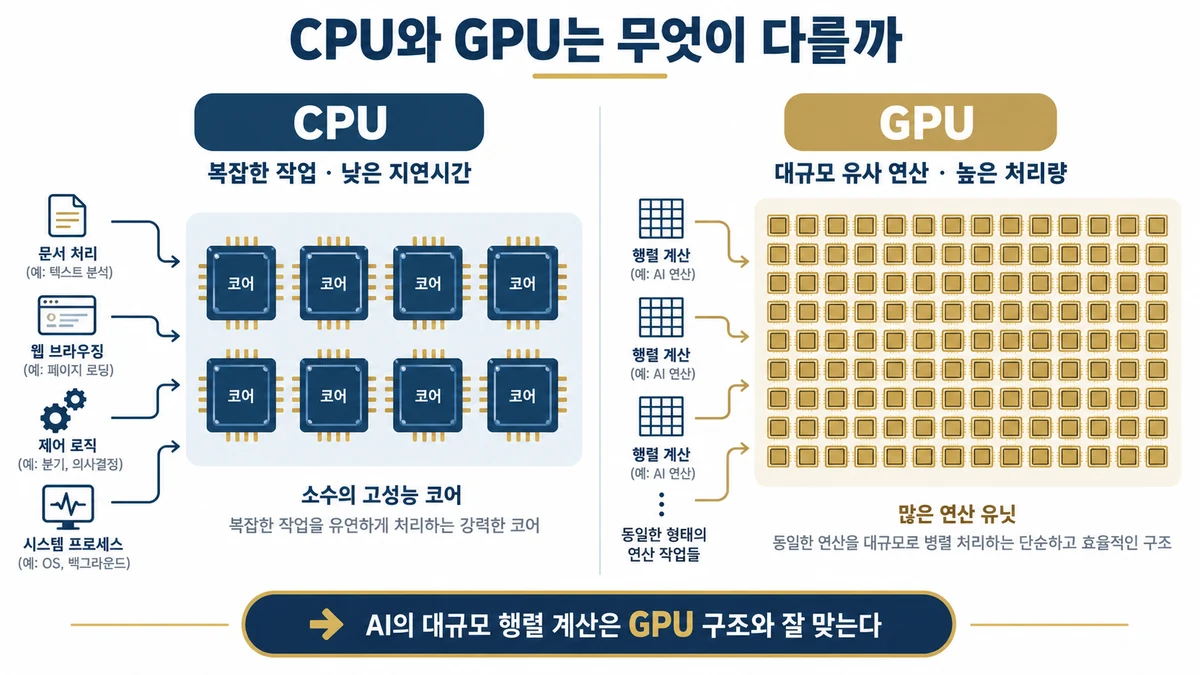
CPU와 GPU를 비교할 때 흔히 CPU를 소수의 뛰어난 전문가, GPU를 같은 계산을 동시에 수행하는 대규모 인력에 비유한다. 입문 단계에서는 꽤 이해하기 쉬운 비유다.
| 구분 | CPU | GPU |
|---|---|---|
| 설계 방향 | 복잡한 작업을 낮은 지연시간으로 처리 | 많은 유사 연산의 전체 처리량을 높임 |
| 구조 | 상대적으로 적은 고성능 코어 | 많은 연산 유닛과 대규모 스레드 |
| 강점 | 분기·제어·범용 작업 | 대규모 반복·병렬 계산 |
| AI에서 역할 | 프로그램 제어, 데이터 준비, 시스템 운영 | 대규모 텐서·행렬 계산 |
CPU와 GPU의 차이는 어느 쪽이 무조건 더 뛰어난가의 문제가 아니다. 서로 잘하는 계산이 다르다.
CPU도 멀티코어와 SIMD 등을 이용해 병렬처리를 한다. 다만 GPU는 훨씬 많은 유사 연산을 동시에 수행해 전체 처리량을 높이는 데 특히 강하다.
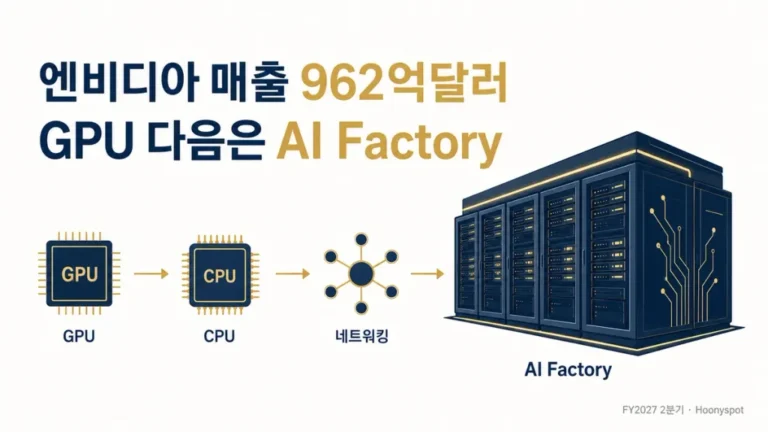
실제 AI 데이터센터에서도 CPU가 없어지는 것은 아니다. CPU가 시스템과 데이터를 관리하고, 대규모 수학 계산을 GPU 같은 가속기가 담당하는 식으로 역할을 나눈다.
AI는 실제로 어떤 계산을 할까
ChatGPT가 문장을 읽는다고 해서 컴퓨터 내부에서 한글이나 영어 문장을 사람과 같은 방식으로 직접 처리하는 것은 아니다.
텍스트는 먼저 토큰(token) 단위로 나뉘고 각각 숫자 ID로 변환된다. 모델 내부에서는 이 토큰들이 다시 여러 차원의 벡터로 표현돼 계산에 사용된다.
서울 → token ID → [0.21, -0.73, 0.18, 0.91, …]
위 숫자는 이해를 돕기 위한 예시다. 중요한 것은 모델 내부에서 결국 숫자 표현을 바탕으로 엄청난 양의 곱셈과 덧셈이 이루어진다는 점이다.
그 중심에 행렬 연산(Matrix Multiplication)이 있다.
[ 1 2 ]
[ 3 4 ]
실제 AI에서는 이런 숫자 배열이 훨씬 거대한 규모가 된다. 수많은 행렬을 곱하고 결과를 더하는 계산이 신경망의 여러 층에서 반복된다.
NVIDIA GPU에 들어가는 Tensor Core 역시 이런 행렬 곱셈과 누산을 빠르게 처리하도록 설계됐다.
AI를 아주 과감하게 단순화하면
엄청나게 많은 숫자를 엄청난 속도로 곱하고 더하면서 데이터 속 패턴을 학습하는 시스템이라고 볼 수 있다.
AI 학습은 실제로 어떻게 이루어질까
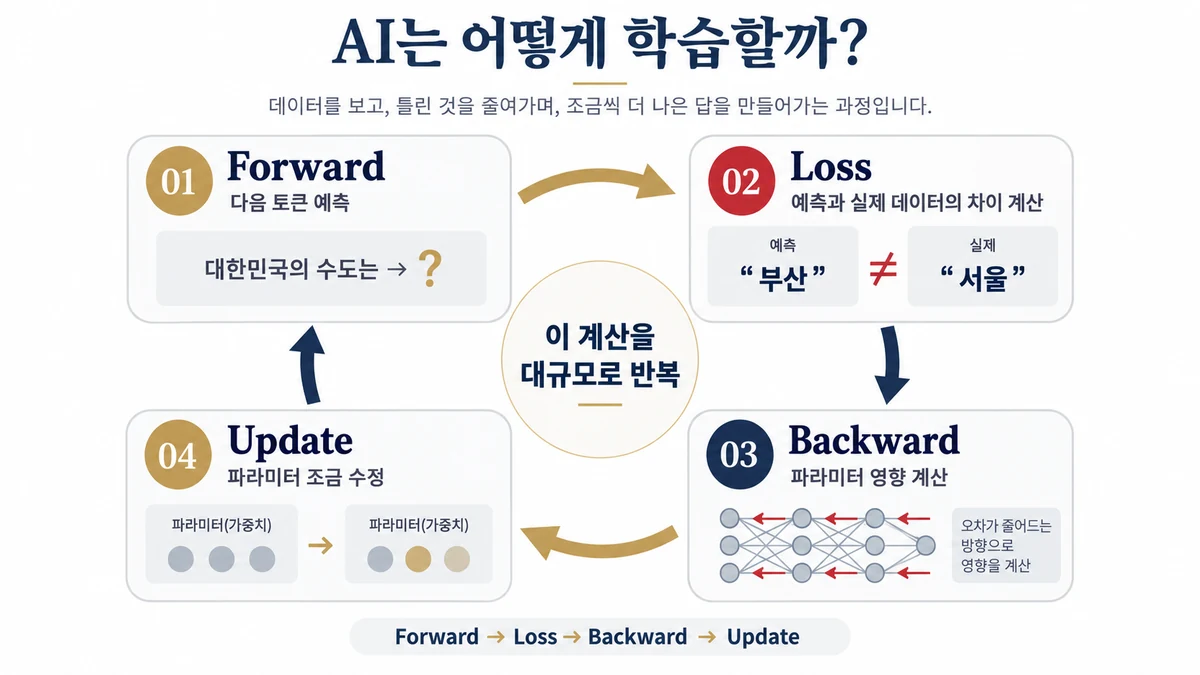
대규모 언어모델의 사전학습은 복잡하지만 입문 단계에서는 Forward → Loss → Backward → Update 네 단계로 이해하면 된다.
1. Forward — 다음 토큰을 예측한다
예를 들어 학습 데이터에 “대한민국의 수도는 서울이다”라는 문장이 있다고 하자.
모델에 “대한민국의 수도는”까지 입력되면 다음에 어떤 토큰이 등장할지 확률을 계산한다. 학습 초기라면 ‘서울’보다 ‘부산’에 높은 확률을 줄 수도 있다.
2. Loss — 예측이 얼마나 빗나갔는지 계산한다
학습 데이터의 실제 다음 토큰이 ‘서울’이었다면 모델이 이 토큰에 얼마나 높은 확률을 부여했는지를 손실 함수로 평가한다. 그 결과가 Loss다.
모델이 “대한민국의 수도는 서울이므로 부산은 틀렸다”고 사람처럼 판단하는 것은 아니다. 사전학습에서는 실제 다음 토큰과 자신의 확률 예측 사이의 차이를 줄이는 방향으로 모델을 조정한다.
3. Backward — 어떤 값을 얼마나 바꿔야 할지 계산한다
Loss가 계산되면 신경망을 거꾸로 따라가며 각 파라미터를 어느 방향으로 얼마나 바꾸면 손실을 줄일 수 있는지 계산한다. 이 과정이 역전파(backpropagation)다.
4. Update — 파라미터를 조금 수정한다
계산된 gradient를 바탕으로 모델 내부의 수많은 파라미터를 조금씩 조정한다.
데이터 입력 → 예측 → Loss 계산 → 역전파 → 파라미터 수정 → 다음 학습
그리고 이 과정 전체에서 거대한 텐서와 행렬 연산이 계속 발생한다.
GPU가 AI에게 역사나 언어를 직접 가르치는 것이 아니다. AI가 학습하는 과정에 필요한 수학 계산을 매우 빠르게 수행하는 것이다.
Training과 Inference는 무엇이 다를까
AI 산업을 투자 관점에서 이해하려면 GPU 수요가 발생하는 두 단계도 구분해야 한다.
| 구분 | Training | Inference |
|---|---|---|
| 의미 | AI 모델을 학습시키는 과정 | 학습된 AI를 실제 사용하는 과정 |
| 주요 계산 | Forward + Backward + 파라미터 업데이트 | 주로 Forward 계산 |
| 예시 | 새로운 대형 언어모델 개발 | AI 서비스가 사용자 질문에 답변 생성 |
| 산업적 의미 | 대규모 집중 투자 | 사용량 증가에 따라 지속적으로 발생하는 연산 수요 |
Training은 AI를 만드는 계산이고, Inference는 만들어진 AI를 계속 사용하는 계산이라고 생각하면 쉽다.
이 구분은 투자에서도 중요하다. 새로운 모델을 만드는 경쟁이 계속되면 학습용 인프라 수요가 발생하고, AI 사용자가 늘어나면 추론을 처리하기 위한 인프라도 필요하다.
결국 AI 시장이 커질수록 중요한 것은 모델 수만이 아니다. 실제로 얼마나 많은 계산이 발생하는가가 반도체와 데이터센터 수요에 직접 연결된다.
GPU 한 장으로는 왜 부족할까
이유 1. 계산량이 너무 많다
대형 언어모델에서는 한 층에서도 여러 번 대규모 행렬 계산이 발생한다. 이런 층이 수십 개 이상 쌓이고, 다시 막대한 양의 학습 데이터에 대해 계산을 반복한다.
고성능 GPU 한 장으로 처리하기에는 계산해야 할 양 자체가 너무 크다.
이유 2. 모델과 학습 상태가 한 장의 메모리에 들어가지 않는다
Meta가 2024년 공개한 Llama 3.1 405B는 약 4,050억 개의 파라미터를 가진 모델이다. Meta는 이 모델을 15조 개가 넘는 토큰으로 학습했다고 밝혔다.
파라미터 하나를 BF16처럼 2바이트로 저장한다고 단순 가정하면 가중치만 약 810GB가 된다.
4050억 × 2바이트 ≈ 810GB
십진 GB 기준의 단순 계산. 실제 학습 메모리 요구량과는 다르다.
비교를 위해 Llama 3.1 학습에 사용된 H100 세대를 보면 NVIDIA H100 SXM의 GPU 메모리는 80GB다.
게다가 실제 학습에서는 가중치만 필요한 것도 아니다. gradient, optimizer state, activation 같은 학습 상태와 중간 계산값도 메모리를 사용한다.
여러 GPU를 사용하는 것은 계산을 빠르게 하기 위해서만이 아니다.
거대한 모델의 파라미터는 물론 gradient, optimizer state, activation 같은 학습 상태도 여러 장에 나눠 저장하고 처리해야 한다.
이유 3. 학습 시간을 현실적인 수준으로 줄여야 한다
한 장에서 계산할 수 있다고 해도 몇 년씩 걸린다면 최신 AI 개발 경쟁에서는 의미가 없다. 그래서 계산을 수천 개, 수만 개의 가속기에 분산한다.
Meta는 Llama 3.1 405B를 학습하면서 1만6천 개가 넘는 H100 GPU를 사용했다고 밝혔다. 2025년 공개한 Llama 4 Behemoth의 사전학습에는 3만2천 GPU가 사용됐다.
따라서 2024~2025년 공개 사례만 보더라도 최첨단 AI 학습은 이미 수만 개의 가속기를 동시에 사용하는 규모까지 커졌다.
수만 개 GPU는 어떻게 하나의 AI를 학습할까
GPU를 여러 개 연결한다고 자동으로 효율적인 학습이 되는 것은 아니다. 모델과 데이터를 여러 장치가 나눠 처리하도록 설계해야 한다.
Data Parallelism
같은 모델을 여러 GPU에 복제하고 각각 서로 다른 학습 데이터 배치를 처리한다. 이후 각 GPU가 계산한 gradient를 학습 스텝마다 동기화해 모델을 함께 업데이트한다.
Tensor Parallelism
하나의 거대한 행렬 계산 자체를 여러 GPU에 나눠 처리한다. 모델 한 부분이 너무 커서 한 장에서 처리하기 어려울 때 중요한 방식이다.
Pipeline Parallelism
모델의 여러 층을 GPU 그룹별로 나눈다. 앞 단계가 계산한 결과를 다음 단계로 전달하는 모습은 공장의 생산라인과 비슷하다.
실제 대규모 모델 학습에서는 이 가운데 하나만 사용하는 것이 아니라 여러 병렬화 방식을 시스템 구조에 맞춰 조합한다.
GPU가 많아질수록 네트워크가 중요해지는 이유
여기부터 AI 반도체 산업을 이해하는 데 중요한 두 번째 단계가 시작된다.
GPU A가 계산한 값을 GPU B가 받아야 다음 계산을 할 수 있는데 데이터 전달이 늦어진다면 GPU B는 기다려야 한다. 수천 개, 수만 개가 동시에 작동하면 이런 통신이 엄청난 규모로 발생한다.
GPU 자체가 아무리 빨라도 장치 사이 통신이 느리면 비싼 연산 능력을 제대로 활용할 수 없다.
GPU 1만 개가 있다고 1만 배 빨라지는 것은 아니다.
수많은 장치가 모델의 일부 값과 gradient 등을 계속 주고받고 동기화해야 하기 때문에 GPU 수가 늘어날수록 통신 성능도 전체 시스템의 성능을 좌우하게 된다.
이것이 NVIDIA가 GPU만 만드는 것이 아니라 NVLink와 네트워크 기술까지 확대해 온 이유 중 하나다. 동시에 대규모 Ethernet과 RDMA도 AI 데이터센터의 핵심 기술로 발전하고 있다.
이 흐름은 2026년 들어서도 더 선명해졌다. Meta는 2026년 8월 MetaRoCE라는 AI 규모 Ethernet용 RDMA 전송 기술을 공개하면서 최첨단 AI 모델의 학습과 추론 모두에서 빠르고 안정적인 GPU 간 통신이 필요하다고 설명했다. Meta는 네트워크의 작은 비효율도 상당한 계산 능력을 놀리게 만들 수 있다고 지적했다.
‘GPU 수십만 개’라는 말은 어떻게 이해해야 할까
AI 기사에서 수십만 개 GPU라는 표현을 접할 때는 하나의 모델 학습에 실제 투입된 GPU 수와 전체 AI 클러스터의 규모를 구분해야 한다.
앞서 본 것처럼 Llama 3.1 405B는 1만6천 개가 넘는 H100, Llama 4 Behemoth는 3만2천 GPU를 사용한 공개 사례다.
반면 Meta는 2025년 공개 자료에서 12만9천 개 H100 규모의 단일 AI 클러스터 구축 사례를 설명했다. 이것이 하나의 모델 학습에 12만9천 개가 모두 투입됐다는 의미는 아니다.
구분해서 보면 된다.
개별 최첨단 모델 학습은 이미 수만 GPU 규모이고, 이를 비롯한 여러 AI 작업을 지원하는 전체 클러스터는 10만 개 이상의 GPU를 묶는 수준까지 커진 사례가 공개돼 있다.
GPU만 늘리면 끝일까? HBM이 필요한 이유
GPU가 아무리 계산이 빨라도 필요한 데이터를 제때 가져오지 못하면 계산 유닛은 기다려야 한다.
그래서 AI 가속기에는 용량뿐 아니라 매우 높은 대역폭을 가진 메모리가 중요하다. HBM이 AI 시대에 핵심 반도체로 부상한 이유가 여기에 있다.
GPU가 계산 엔진이라면 HBM은 엔진 바로 옆에서 계산 재료를 빠르게 공급하는 초고속 창고라고 비유할 수 있다.
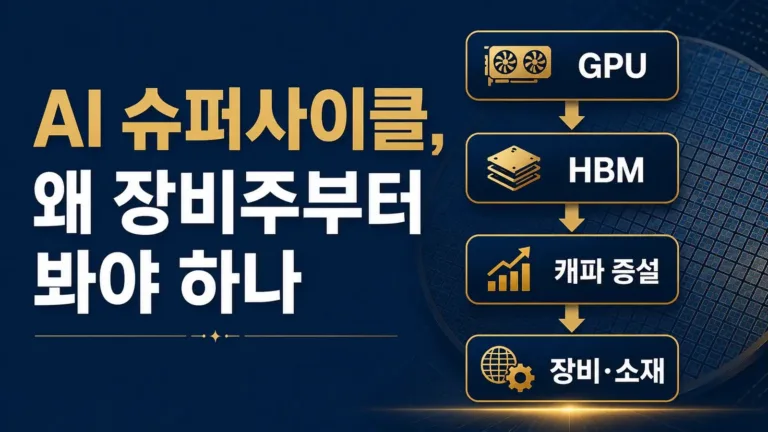
여기서 산업의 연결고리가 하나 더 생긴다. AI 계산량이 증가하면 GPU만 필요한 것이 아니라 HBM과 첨단 패키징, 네트워크 장비까지 함께 중요해진다.
이제 경쟁의 단위는 GPU 개수에서 전력으로 커지고 있다
수만 개의 GPU를 연결하기 시작하면 반도체만의 문제가 아니다. 서버를 놓을 건물, 냉각 설비, 네트워크 그리고 무엇보다 막대한 전력이 필요하다.
Meta는 2026년 2월 공식 Engineering 자료에서 Prometheus를 완성 시 1GW 용량의 AI 클러스터로 설명했다. 여러 데이터센터 건물에 걸쳐 수만 개 GPU를 연결하는 구조다.
Meta가 2025년 발표한 더 큰 프로젝트 Hyperion은 2028년부터 가동을 시작하고, 완성 시 최대 5GW까지 확장할 수 있도록 계획돼 있다.
Moneygrammar의 해석
AI 인프라 경쟁의 단위가 GPU 몇 개를 확보했는지에서 데이터센터 전체가 얼마만큼의 계산 능력과 전력을 확보할 수 있는지로 커지고 있다. NVIDIA를 이해하려다 HBM을 보게 되고, HBM을 따라가면 네트워크와 전력·냉각·데이터센터 산업까지 연결되는 이유가 여기에 있다.
이 기술 구조가 빅테크 투자와 무슨 관계가 있을까
여기까지는 기술 이야기였다. 하지만 이 구조를 이해하고 나면 NVIDIA, AMD, Google, Amazon, Microsoft, Meta 같은 기업을 바라보는 기준도 달라진다.
AI 경쟁에서 중요한 것은 단순히 “누가 가장 좋은 AI 모델을 만들었는가”만이 아니다.
그 모델을 학습하고 수많은 사용자에게 서비스하기 위해 얼마나 많은 계산이 필요하며, 그 계산을 얼마나 낮은 비용으로 공급할 수 있는가도 기업의 경쟁력에 영향을 준다.
| 기술적으로 생기는 문제 | 필요해지는 산업 | 투자자가 볼 질문 |
|---|---|---|
| AI 계산량 증가 | GPU·AI 가속기 | 누가 계산 능력을 가장 경쟁력 있게 공급하는가 |
| 데이터 공급 병목 | HBM·첨단 패키징 | 메모리 공급과 기술 격차는 어떻게 변하는가 |
| GPU 간 통신 증가 | NVLink·Ethernet·광통신 | 가속기를 얼마나 효율적으로 묶을 수 있는가 |
| 데이터센터 확대 | 전력·냉각·변압기·데이터센터 | 컴퓨팅 확대를 실제 인프라가 따라갈 수 있는가 |
| AI 서비스 사용량 증가 | 추론용 가속기·자체 AI 칩 | 토큰당 비용과 전력 효율을 누가 낮추는가 |
예를 들어 NVIDIA를 단순히 “GPU를 많이 파는 회사”로 보면 현재 AI 산업의 일부만 보게 된다. 반대로 Google과 Amazon이 왜 TPU와 Trainium 같은 자체 AI 칩에 투자하는지도 계산 비용이라는 관점에서 바라보면 훨씬 이해하기 쉬워진다.
AMD가 NVIDIA의 경쟁자가 될 수 있는지를 판단할 때도 GPU의 단일 벤치마크만 볼 것이 아니라 소프트웨어, 메모리, 네트워크, 대규모 클러스터 운영까지 함께 봐야 한다.
이 시리즈에서 앞으로 볼 질문
“AI가 성장할까?”에서 끝내지 않고, AI 사용량 증가가 실제로 어느 기업의 매출과 이익으로 연결되는가를 기술 구조부터 따라가 보는 것이 목표다.
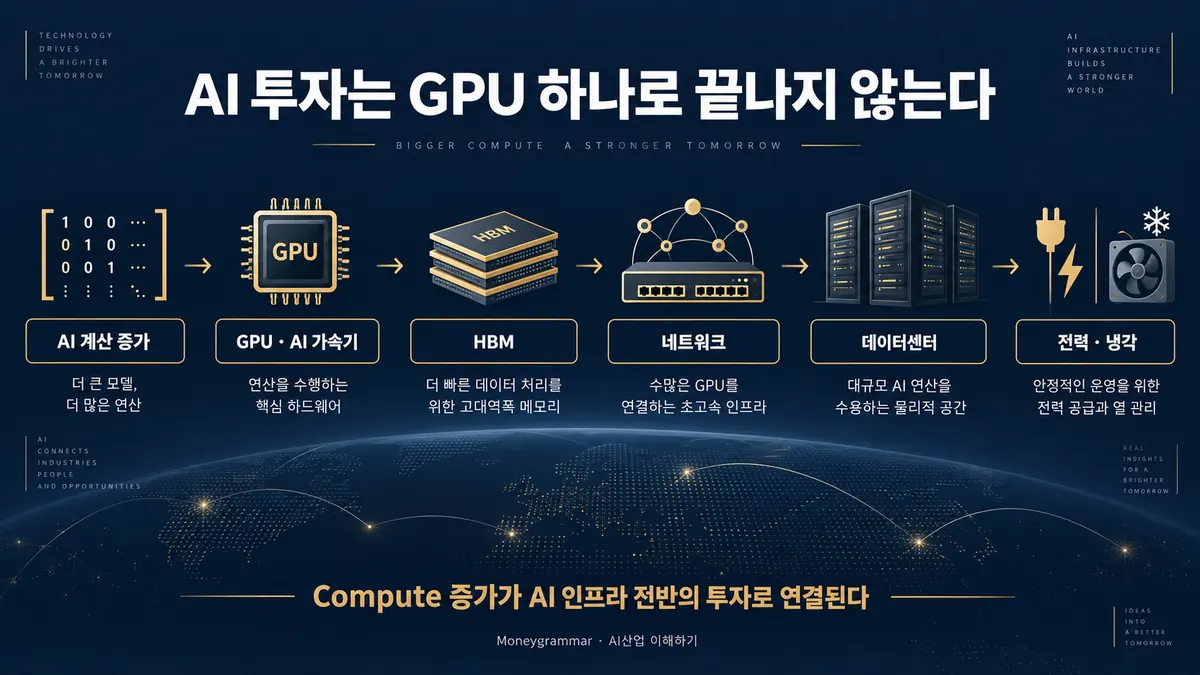
AI 시대의 핵심 자원은 결국 Compute다
지금까지의 흐름을 한 번에 연결해보면 AI 산업에서 왜 이렇게 막대한 투자가 발생하는지 보이기 시작한다.
더 뛰어난 AI를 만들려 한다
↓
더 많은 계산이 필요하다
↓
GPU·AI 가속기 수요가 증가한다
↓
HBM과 첨단 패키징이 필요해진다
↓
수많은 가속기를 연결할 네트워크가 필요하다
↓
대규모 데이터센터를 건설한다
↓
전력·냉각·광통신 등 인프라 투자가 증가한다
↓
AI 서비스 사용량이 늘면 추론 계산이 다시 증가한다
결국 AI 시대에 중요한 자원은 데이터만이 아니다.
Compute, 즉 계산 능력 자체가 핵심 산업 인프라가 되고 있다.
이 구조를 이해하면 앞으로 빅테크의 AI 관련 투자를 볼 때 단순히 “CAPEX가 많이 늘었다”는 숫자만 보지 않게 된다. 그 돈이 GPU에 들어가는지, 자체 칩에 들어가는지, 데이터센터와 전력 인프라에 들어가는지, 그리고 그 투자가 실제 AI 서비스 매출과 비용 절감으로 이어지는지를 따져볼 수 있다.
그것이 AI 기술을 먼저 이해하고 빅테크 투자를 바라봐야 하는 이유다.
그런데 다음 질문이 남는다.
GPU 성능이 비슷해진다면 아무 회사의 GPU나 사용하면 되는 것 아닐까? 실제로는 그렇지 않다. 수많은 AI 개발 환경이 NVIDIA의 CUDA를 중심으로 구축돼 있고, GPU를 대규모로 연결하는 NVLink와 네트워크까지 하나의 시스템으로 움직인다.
참고한 공식 자료
- NVIDIA CUDA Programming Guide — GPU 구조와 CUDA
- PyTorch — Automatic Differentiation과 Backpropagation
- Meta — Llama 3.1 405B 학습 규모
- Meta — Llama 4 Behemoth 학습 규모
- NVIDIA — H100 Tensor Core GPU 공식 사양
- Meta Engineering — 129K H100 클러스터와 Hyperion
- Meta Engineering — 2026 Prometheus 1GW AI 클러스터
- Meta Engineering — MetaRoCE와 AI 규모 Ethernet
- NVIDIA Megatron Core — 대규모 AI 모델 병렬화
글쓴이 Moneygrammar
Moneygrammar는 기업 공시, 정부·공공기관 자료와 경제지표를 확인하고 필요한 경우 직접 계산해 금융·경제 이슈를 이해하기 쉽게 정리합니다. 본문의 수치와 제도는 발행 시점 기준이며 이후 변경될 수 있습니다.