Maia 300 랙 하나에는 HBM4가 768개 들어간다. 마이크로소프트가 2026년 10월 12일 공개한 3세대 자체 AI 가속기 Maia 300은 칩 한 개에 HBM4 8스택(288GB)을 붙이고, 이 칩 96개를 167kW짜리 랙 하나에 담는다. 실제 데이터센터 배치는 2027년부터다.
투자자가 따져야 할 질문은 “엔비디아가 끝나느냐”가 아니다. 이 칩이 HBM·파운드리·전력 수요를 새로 늘리는지, 아니면 GPU에 가던 몫을 옮겨 가는지다. 공개 사양만으로 계산할 수 있는 데까지 계산해 봤다.
3줄 요약 (확인일 2026-10-13)
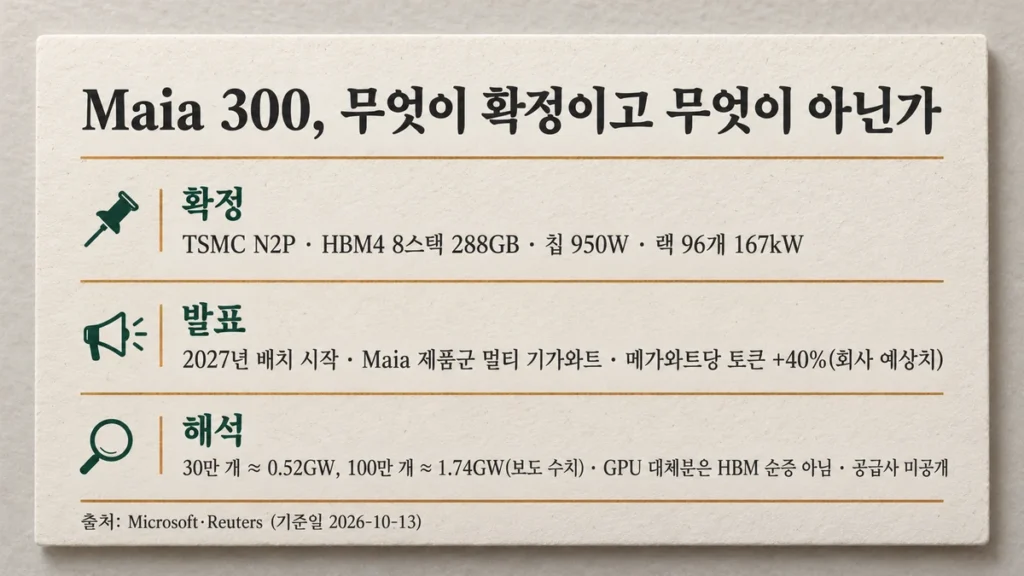
📌 확정 사양 — TSMC N2P 연산 칩렛, HBM4 8스택·288GB·18TB/s, 칩 TDP 950W, 랙당 가속기 96개·전력 한도 167kW
📢 회사 발표 — Maia 300은 2027년 생산 배치 시작. Azure Maia 제품군 전체는 2027년부터 ‘멀티 기가와트’ 규모로 확대해 자사 제품의 주력 추론 시스템으로 삼을 계획. 선도 GPU 시스템 대비 메가와트당 토큰 40% 증가(회사 예상치)
🔎 머니그래머 해석 — HBM 수요처가 넓어진다는 점은 긍정적이다. 다만 GPU를 대체하는 몫은 메모리 순증이 아니고, Maia 300의 HBM4 공급사와 물량은 아직 공개되지 않았다.
Maia 300 공식 사양 — 메모리가 연산보다 훨씬 빨리 늘었다
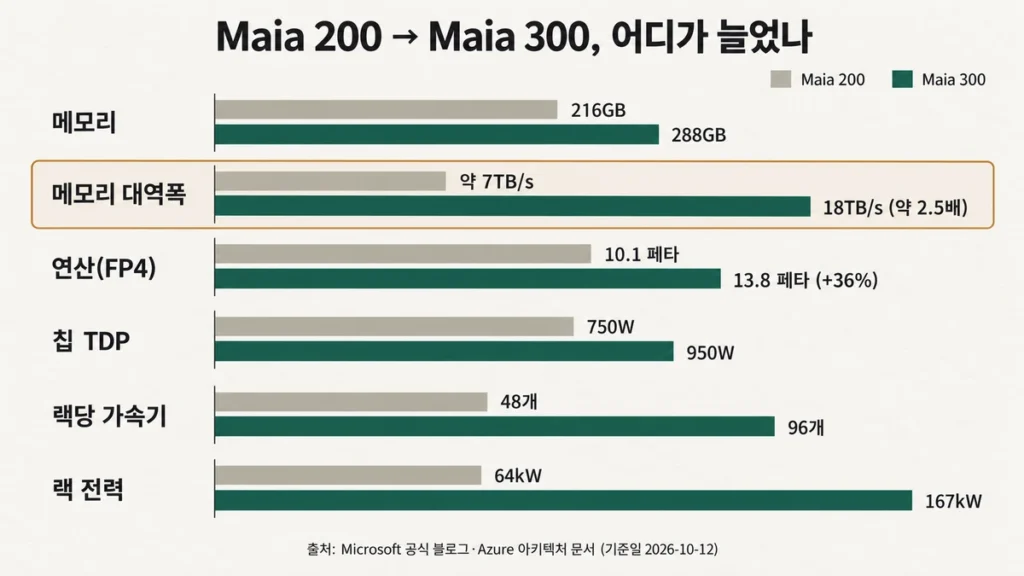
Maia 300은 OCP 글로벌 서밋에서 공개됐다. 1월에 나온 Maia 200과 나란히 놓으면 어디에 설계 자원을 몰았는지가 바로 보인다.
| 항목 | Maia 200 | Maia 300 | 변화 |
|---|---|---|---|
| 공개일 | 2026.01.26 | 2026.10.12 | — |
| 공정 | TSMC 3nm 단일 다이 | TSMC N2P 연산 칩렛 + 3nm 입출력 칩렛 | 멀티 칩렛 전환 |
| 메모리 | HBM3E 6스택 · 216GB | HBM4 8스택 · 288GB | +33% |
| 메모리 대역폭 | 약 7TB/s | 18TB/s | 약 2.5배 |
| 연산 성능(FP4) | 10.1 페타 | 13.8 페타 | +36% |
| 칩 TDP | 750W | 950W | +27% |
| 랙당 가속기 | 48개 | 96개 | 2배 |
| 랙 전력 한도 | 64kW | 167kW | 약 2.6배 |
| 랙당 HBM 용량 | 약 10.4TB | 27.6TB | 약 2.7배 |
| 상태 | 운영 중 | 2027년 배치 예정 | 📢 발표 단계 |
출처: Microsoft 공식 블로그·Azure 아키텍처 문서(2026-10-12), Maia 200 공식 발표(2026-01-26). FP4 연산값과 Maia 200 랙 전력(64kW)은 기술 매체가 공식 문서를 정리한 수치, 3nm 입출력 칩렛은 로이터 보도(2026-10-12). 대역폭 배수는 Microsoft 설명 기준. Maia 200 랙 HBM 용량은 48×216GB 직접 계산. 확인일 2026-10-13.
가속기 1개 기준 — 연산과 메모리 대역폭 증가폭 비교
연산(FP4) Maia 200 → 300 : +36%
메모리 대역폭 Maia 200 → 300 : 약 2.5배(+150%)
막대 길이는 증가율(%) 비례. 연산 +36%, 대역폭 약 2.5배는 Microsoft 아키텍처 문서 설명 기준.
연산은 36% 늘었는데 대역폭은 2.5배가 됐다. 마이크로소프트는 대형 추론 시스템의 병목이 연산 능력이 아니라 데이터 이동이라고 설명한다. 긴 대화를 처리할수록 AI는 이전 맥락을 담은 중간 데이터(KV 캐시)와 모델 가중치를 메모리에서 끊임없이 퍼 와야 한다. 이 구간에서는 연산 유닛이 메모리를 기다리며 노는 시간이 길어진다. Maia 300은 메모리 접근과 데이터 이동을 줄이는 방향으로 설계됐다.
HBM4 8개 — 랙 하나에 768스택, 1GW면 약 460만 스택
국내 투자자에게 가장 직접적인 숫자는 HBM이다. 칩 단위가 아니라 랙과 전력 단위로 환산해야 규모가 보인다.
🧮 공식 사양으로 계산한 HBM4 물량
· 랙 1개 : 96개 × 8스택 = 768스택, 27.6TB
· 슈퍼포드 1개(최대 128랙) : 가속기 12,288개 · 98,304스택 · 약 3.54PB
· 슈퍼포드 128랙의 전력 한도 합계 : 약 21.4MW
이번 공식 발표에는 칩 개수가 없다. 마이크로소프트는 2027년부터 Azure Maia 제품군 전체를 멀티 기가와트 규모로 확대하겠다고 했고, Maia 300도 2027년부터 생산 배치에 들어간다고 했다. 이 전력이 모두 Maia 300 몫인지, 언제까지 채우는지는 발표에 없다. 그래서 “그 전력을 전부 Maia 300 랙으로 채운다면”이라는 조건을 걸고 전력을 칩 수로 바꿔 봤다.
| 랙 전력 합계 | 랙 수 | 가속기 | HBM4 스택 | HBM 용량 |
|---|---|---|---|---|
| 약 0.52GW | 3,125 | 30만 개 8월 보도 수치 | 240만 | 86.4PB |
| 1GW | 5,988 | 약 57.5만 개 | 약 460만 | 약 165.6PB |
| 약 1.74GW | 10,417 | 100만 개 10월 보도 수치 | 800만 | 288PB |
🧮 직접 계산: 랙 167kW·랙당 96개·가속기당 8스택 288GB 기준. 랙 전력 한도만 더한 값이며, 데이터센터 ‘기가와트’는 보통 냉각·변전 손실을 포함한 시설 전력이라 같은 1GW에 실제로 들어가는 랙은 이보다 적다. 불량률·예비 재고 제외. 확정 발주량이 아니다.
표의 30만 개와 100만 개는 근거가 있는 숫자다. 2026년 8월 미국 매체 The Information은 마이크로소프트가 2027년 인도분으로 TSMC와 30만 개 이상의 생산능력을 협상 중이라고 보도했다. 당시 마이크로소프트는 보도된 수치가 프로그램 규모를 반영하지 않는다고만 답했다. 이어 발표 당일인 10월 12일 로이터는 마이크로소프트가 2027년에 Maia 300을 100만 개 넘게 배치할 수 있다고 전했다.
계산하면 30만 개는 랙 전력 기준 약 0.52GW, 100만 개는 약 1.74GW다. 100만 개 쪽이 ‘멀티 기가와트’라는 회사 표현과 규모가 맞물린다. 그래도 두 수치 모두 보도이고, 확정 출하량이 아니다. 마이크로소프트가 직접 공개한 것은 전력 규모뿐이다.
HBM4 공급사는 아직 공개되지 않았다
| 기업 | 확인된 HBM4 현황 | Maia와의 관계 |
|---|---|---|
| SK하이닉스 | 2분기 실적 발표(2026-07)에서 주요 고객 대상 HBM4 양산 공급 시작을 밝힘 | Maia 200의 HBM3E 단독 공급사로 보도(2026-01). Maia 300 공급 여부 미확인 |
| 삼성전자 | 2026-02-12 업계 최초 HBM4 양산 출하 발표 | Maia 300 공급 여부 미확인 |
| 마이크론 | 2026-06-24 실적 발표 콘퍼런스콜에서 HBM4 누적 출하 10억 달러 초과 언급 | Maia 300 공급 여부 미확인 |
출처: 삼성전자 발표(2026-02-12), SK하이닉스 2분기 실적 발표(2026-07), 마이크론 회계연도 3분기 실적 발표(2026-06-24), TrendForce(2026-01, 국내 경제지 인용). 확인일 2026-10-13.
전 세대 Maia 200에 SK하이닉스 HBM3E가 들어갔다는 보도가 있었으니 연속성을 기대할 수는 있다. 그러나 보도이고 회사 확인이 아니다. 삼성전자가 HBM4를 먼저 양산했다는 사실도 Maia 300 납품과는 별개다. 어느 회사 이름이든 “Maia 300 수혜주”로 단정할 근거는 아직 없다. 지난 10년 HBM 점유율이 어떻게 갈렸는지는 HBM 10년의 인내, 보상은 나뉘고 있다에서 따로 정리했다.
순증인가, 대체인가 — 이 계산이 빠지면 수혜가 부풀려진다
엔비디아의 차세대 Rubin GPU도 GPU 한 개에 288GB HBM4를 쓴다. 가속기 한 개당 메모리 용량이 같다는 뜻이다. Rubin 1개 살 자리에 Maia 300 1개가 들어가는 식으로 수량이 일대일로 대체된다면, 메모리 용량 기준 수요는 늘지 않는다. 바뀌는 건 메모리를 누가 납품하느냐, 즉 공급사 배분이다.
다만 현실에서 대체가 정확히 일대일로 일어나지는 않는다. 두 시스템의 처리량과 랙 구성이 달라서, 같은 서비스를 돌리는 데 필요한 가속기 수가 달라질 수 있다. Maia 300이 회사 주장대로 같은 전력에서 토큰을 더 많이 뽑는다면, 같은 작업에 필요한 칩 수가 줄어 HBM 탑재량도 함께 줄어드는 방향이 될 수 있다. 반대로 비용이 내려가 서비스 사용량 자체가 늘면 총 설치량은 커진다. 결국 HBM 순증 여부는 칩 한 개당 용량이 아니라 전체 가속기 도입량 × 가속기당 탑재량으로 봐야 한다.
HBM 산업 전체가 커지는 경우는 두 가지다. 자체 칩이 GPU를 빼지 않고 추론 설비에 얹히는 경우, 그리고 AI 서비스 수요가 커져 GPU와 자체 칩의 총 설치량이 함께 늘어나는 경우다.
🔎 머니그래머 해석 — Maia 300은 HBM4 수요처가 엔비디아 밖으로 넓어진다는 증거다. 메모리 회사 입장에서는 고객 한 곳에 대한 의존이 줄어드는 효과가 크다. 다만 이 발표 하나로 특정 회사의 2027년 HBM 매출 증가분을 계산할 수는 없다. 실제 투자 변수는 “총 HBM 수요”보다 “Maia 물량에서 각 사가 가져가는 몫”이다.
167kW 서버랙 — 칩 950W와 랙 전력은 다르다
167kW는 칩 한 개 전력이 아니라 가속기 96개와 주변 장치를 다 합친 랙 단위 전력 한도다. 칩 몫과 나머지를 나눠 보면 이렇다.
🧮 167kW 랙 전력 분해
칩 TDP 91.2kW
나머지 75.8kW
· 96개 × 950W = 91.2kW (한도의 54.6%)
· 가속기 슬롯 1개당 전력 한도 약 1.74kW (Maia 200은 64kW ÷ 48 ≈ 1.33kW)
75.8kW는 설계 한도와 칩 TDP 합계의 산술적 차이다. 주변 장치의 실측 소비전력이 아니다.
나머지 전력이 들어가는 곳은 마이크로소프트의 아키텍처 문서에 꽤 구체적으로 나와 있다.
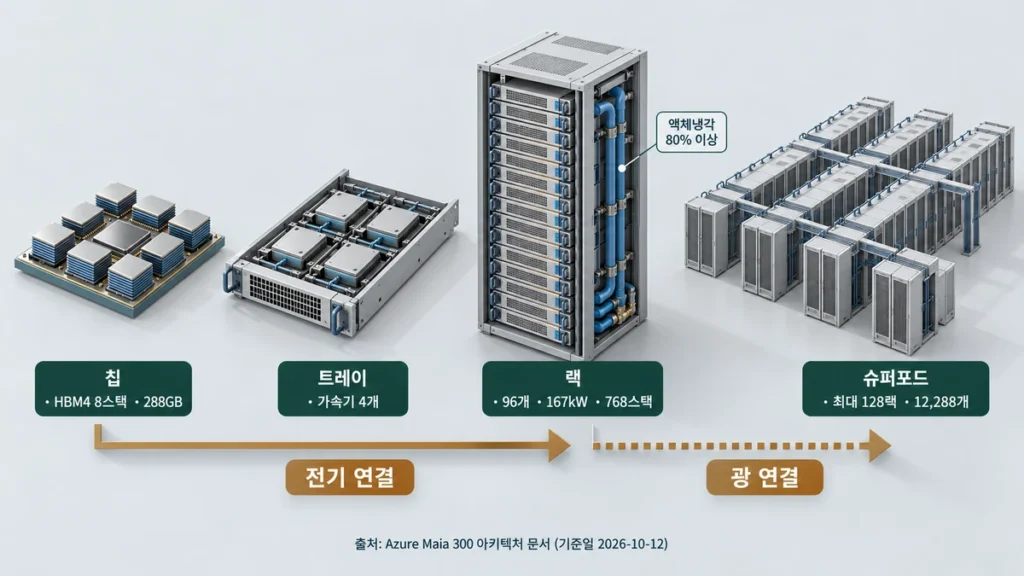
· 가속기 4개짜리 트레이 24개, 랙 안은 전기 신호로 연결
· 스위치 칩 6개를 액체냉각 스위치 트레이 3개에 배치
· 이중 전원 공급 + 50V 버스바로 배전
· 액체냉각이 랙 열부하의 80% 이상 제거, 시설 냉각수 직결 또는 열교환기로 공랭 데이터센터에도 설치
· 랙과 랙 사이는 광 스위치로 연결해 최대 128랙까지 확장
투자 관점에서 눈여겨볼 부분은 랙 전력이 한 세대 만에 2.6배가 됐다는 점이다. 167kW급 랙이 표준이 되면 랙당 배전·냉각 설비의 사양과 단가가 같이 올라간다. 광 연결도 랙 안이 아니라 랙 사이에 쓰인다는 점을 구분해야 광부품 수혜를 과장하지 않는다. 다만 이 발표에는 장비 공급사가 한 곳도 나오지 않는다. 167kW라는 숫자만으로 특정 전력·냉각 기업의 수주를 계산할 수는 없다. 서버·전력·냉각 업체의 수요 원인과 이익률이 어떻게 다른지는 GPU가 바뀌면 서버·전력·냉각도 바뀐다에서 Dell·HPE·Vertiv 실적으로 비교했다.
‘메가와트당 토큰 40%’를 전력으로 바꾸면 28.6%
마이크로소프트가 내놓은 성능 수치는 기준이 서로 다르다. 섞어 읽으면 오해가 생긴다.
| 회사 주장 | 비교 대상 | 성격 |
|---|---|---|
| 메가와트당 토큰 +40% | “선도 GPU 기반 시스템” (모델명 미공개) | 📢 회사 예상치 |
| 랙당 토큰 처리량 최대 7배 | Maia 200 랙(48개) | 📢 회사 제시 |
| 와트당 성능 2.5배 이상 | Maia 200 | 📢 회사 제시 |
출처: Microsoft 공식 블로그·Azure 아키텍처 문서(2026-10-12). 확인일 2026-10-13.
40%는 비교 대상 GPU, AI 모델, 입출력 길이, 전력 측정 범위가 모두 공개되지 않았다. 엔비디아 최신 GPU 전체보다 40% 낫다는 뜻으로 읽으면 안 된다. 그래도 이 수치가 같은 작업에서 그대로 실현된다고 가정하면 경제적 의미를 계산해 볼 수는 있다.
🧮 같은 양의 토큰을 처리한다면
· 비교 GPU 시스템 1.00MW → Maia 300 약 0.714MW (1 ÷ 1.4)
· 이론상 전력 28.6% 절감
동일 작업·품질·지연시간 가정 시나리오. Maia 300의 측정된 절감률이 아니다.
🧮 ‘7배’를 쪼개 보면
· 랙 처리량 7배 ÷ 랙 전력 2.6배(167÷64) ≈ 2.7배 → 회사가 말한 ‘와트당 성능 2.5배 이상’과 대체로 맞는다
· 랙 처리량 7배 ÷ 가속기 수 2배 → 가속기당 평균 처리량으로 단순 환산하면 최대 약 3.5배
3.5배는 칩 단독 벤치마크가 아니다. 소프트웨어·네트워크·랙 설계 개선 효과가 함께 들어간 시스템 수치를 나눈 값이다.
즉 7배라는 숫자의 상당 부분은 랙에 칩을 두 배로 넣고 전력을 2.6배로 늘린 데서 나온다. 칩 하나가 7배 좋아진 게 아니다. 그리고 전력을 아낀다고 총소유비용(TCO)이 같은 비율로 내려가지는 않는다. 칩·랙 구매비, 감가상각, 소프트웨어 최적화 비용, 가동률이 함께 들어가기 때문이다. 마이크로소프트에게 중요한 지표는 칩 한 개의 이론 연산량보다 실제 서비스에서 나오는 토큰당 총비용이다.
엔비디아·TSMC·메모리 — 누가 실제 물량을 가져가나
투자자가 사양표보다 먼저 볼 문장은 따로 있다. 마이크로소프트는 2027년부터 Maia 제품군을 자사 제품·서비스의 주력 추론 시스템으로 만들겠다고 했다. 코파일럿 같은 자체 서비스의 반복 추론은 점점 자기 칩으로 옮기겠다는 뜻이다. 반면 모델 학습과 애저 외부 고객용 연산은 여전히 GPU 몫으로 남는다. 마이크로소프트도 GPU 구매를 멈춘다고 말한 적은 없다. GPU와 자체 칩이 함께 늘 때 어느 공급사가 계속 주문을 받는지는 AI 데이터센터 반복투자, 누가 계속 주문을 받나에서 다뤘다.
| 기업·산업 | 구조적 영향 | 아직 모르는 것 |
|---|---|---|
| 마이크로소프트 | 자체 서비스 추론 비용을 직접 통제 | 배치 규모·일정, 실제 비용 개선폭 |
| 엔비디아 | MS 내부 추론에서 경쟁 압력 | MS의 GPU 발주가 실제로 줄어드는지 |
| TSMC | GPU든 자체 칩이든 첨단 공정 수요는 유지 | GPU 주문 대체분을 뺀 순증 물량, 패키징 구성 |
| SK하이닉스·삼성전자·마이크론 | HBM4 고객 다변화 | Maia 300 공급사와 배분 비율 |
| 전력·냉각·광통신 | 167kW·액체냉각 랙 확대 시 장비 수요 | 공급사, 수주 규모, 수익성 |
| 브로드컴·마벨 | 빅테크 맞춤형 칩 시장 성장의 일반적 수혜 | Maia 300 관여 여부 미확인 |
🔎 머니그래머 정리. 확인일 2026-10-13.
TSMC는 N2P 양산 시점을 2026년 하반기로 제시해 왔다. Maia 300은 연산 칩렛만 N2P로 만들고 메모리 컨트롤러와 입출력은 별도 칩렛으로 뺐다. 로이터는 데이터 이동을 맡는 칩렛이 비용이 낮은 3nm 공정이라고 전했다. 기능마다 맞는 공정을 쓰는 설계라 첨단 패키징 수요와도 연결되지만, 어떤 패키징을 누가 맡는지는 공개되지 않았다. TSMC의 강점은 특정 GPU의 성패와 상관없이 칩을 설계하는 쪽이 누구든 첨단 공정을 맡는다는 데 있다. 대신 엔비디아 주문이 마이크로소프트 주문으로 바뀌는 부분은 순수한 추가 매출로 볼 수 없다. 공정 구성·패키징·단가가 서로 달라서 같은 수의 칩이 대체되더라도 TSMC 매출 영향은 일대일로 상쇄되지도, 그대로 더해지지도 않는다.
🔎 머니그래머 해석 — AI 칩을 누가 설계하든 메모리·공정·전력·냉각은 필요하다. 산업 전체 수요의 바닥은 더 넓어진다. 하지만 산업 성장과 개별 기업의 이익 증가는 다른 문제다. 공급망에 이름이 있다는 것만으로 수혜를 계산하지 않는다.
2027년까지 확인할 네 가지
① 생산 배치 시작 시점과 초기 규모
‘2027년’과 ‘멀티 기가와트’ 사이의 구체적인 일정이 나오는지. 30만·100만 개 보도 중 어느 쪽이 공식 숫자로 확인되는지.
② HBM4 공급사 공개
메모리 3사 분기 실적 발표에서 맞춤형 칩(ASIC) 고객 물량이 언급되는지가 가장 빠른 단서다.
③ 외부 고객 확보
고객 접근 방식과 가격은 아직 발표되지 않았다. 외부 AI 기업과의 협상 보도는 있었지만 회사 확인은 없다.
④ 같은 조건의 독립 비교
동일 모델·동일 입출력 길이·동일 지연시간에서 GPU와 비교한 결과가 나와야 ‘40%’를 판단할 수 있다.
자주 묻는 질문
Q. Maia 300 때문에 엔비디아 실적이 바로 줄어드나요?
아직 판단하기 어렵습니다. Maia 300의 실제 배치는 2027년부터이고, 마이크로소프트는 학습용과 외부 고객용으로 GPU를 계속 쓰고 있습니다. 영향은 마이크로소프트 내부 추론 물량이 얼마나 빨리 옮겨 가느냐에 달려 있습니다.
Q. SK하이닉스나 삼성전자가 Maia 300에 HBM4를 공급하나요?
2026년 10월 13일 기준으로 공식 확인된 공급사는 없습니다. 전 세대인 Maia 200에 SK하이닉스 HBM3E가 쓰였다는 보도는 있었지만, 이것도 회사가 확인한 내용은 아닙니다.
Q. ‘HBM4 8개’는 다른 AI 칩보다 많은 건가요?
가속기 한 개당 288GB는 엔비디아 Rubin GPU와 같은 수준입니다. 차이는 칩 한 개보다 랙 구성에서 나옵니다. Maia 300은 랙 하나에 96개를 넣어 랙당 HBM이 27.6TB, 768스택에 이릅니다.
이 글은 일반적인 정보 제공을 위한 내용이며 특정 종목의 매수·매도를 권하지 않습니다. 성능 수치는 회사 발표 기준이고, 물량 계산은 공개 사양으로 만든 시나리오입니다. 투자 판단 전 최신 공시와 공식 자료를 다시 확인하시기 바랍니다.
참고자료 (확인일 2026-10-13)
· Microsoft 공식 블로그, Microsoft to expand Azure Maia system to multi-gigawatt deployments (2026-10-12)
· Microsoft Azure 블로그, Deep dive into Azure Maia 300 architecture (2026-10-12)
· Microsoft, Maia 300 미디어 자료 (2026-10-12)
· Microsoft 공식 블로그, Maia 200: The AI accelerator built for inference (2026-01-26)
· Micron, 회계연도 2026년 3분기 실적 보도자료(SEC 8-K) (2026-06-24)
· Reuters, Maia 300 공개 및 2027년 배치 계획 보도 (2026-10-12) / The Information, TSMC 생산능력 협상 보도 (2026-08-10)
· HPCwire, Microsoft Boosts HBM Bandwidth by 2.5x with Maia 300 (2026-10-12)
· StorageReview, Maia 300 사양 비교 (2026-10-12)
· TrendForce, Maia 200 HBM3E 공급사 보도 (2026-01)
· 삼성전자 글로벌 뉴스룸, HBM4 양산·상업 출하 발표 (2026-02-12)
· SK하이닉스 뉴스룸, 2026년 2분기 실적 발표 (2026-07)